> Antworte auf Deutsch und schreib auch alle Kommentare im Code auf Deutsch.
# Aufgabe: Meine Website für KI-Suchmaschinen lesbar machen
Du bist Experte für technisches SEO und GEO (Generative Engine Optimization, also Optimierung für generative Suchmaschinen: ChatGPT Search, Claude, Perplexity, Google AI Overviews, Copilot).
## Kontext
- Analysierte Website: http://harborcyclery.example/
- Datum der Analyse: 24.9.2026
- Aktuelle Punktzahl für KI-Sichtbarkeit: 36/100 (Note F)
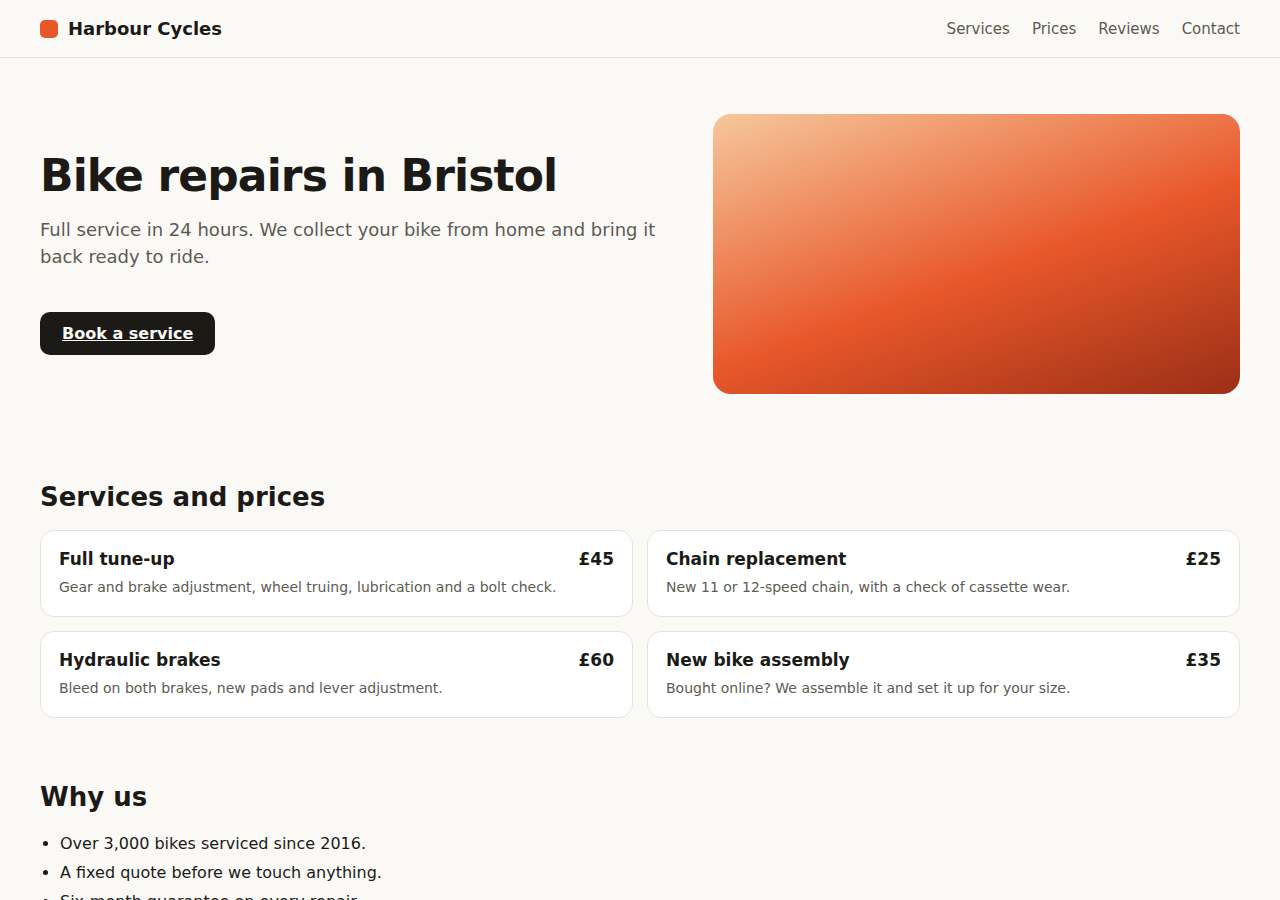
- Parität Mensch/KI: Ein Besucher sieht 160 Wörter, ein KI-Crawler erhält 0 (0 %).
- Aktueller Seitentitel: "Harbor Cyclery"
- Vorhandene strukturierte Daten: keine
## Punktzahl nach Bereich
- Zugriff für KI-Crawler: 83/100
- Für KI sichtbare Inhalte: 15/100
- Struktur und Semantik: 25/100
- Strukturierte Daten: 14/100
- Inhalte, die Fragen beantworten: 5/100
- Technik: 71/100
## Die Konkurrenz
Bei derselben Frage wählt eine KI zwischen diesen Websites. Die Zahlen stammen aus einer echten Analyse nach denselben Kriterien:
- bristolbikeworks.example: 79/100, 588 lesbare Wörter
- quaysidecycles.example: 55/100, 231 lesbare Wörter
- harborcyclery.example (meine Website): 36/100, 0 lesbare Wörter
## Was du tun sollst
Behebe die Probleme aus der folgenden Liste **in der Reihenfolge, in der sie stehen** (sie sind danach sortiert, wie stark sie beeinflussen, ob eine KI mich überhaupt zitieren kann).
Für jedes Problem:
1. Finde in meinem Projekt die Datei oder das Template, in dem es entsteht.
2. Setz die Änderung passend zu meinem tatsächlichen Stack um (kopiere die Beispiele nicht wörtlich, nimm sie als Vorlage).
3. Erklär mir in einem Satz, was du geändert hast und warum.
4. Sag mir, wie ich prüfe, ob es funktioniert hat.
Wenn etwas eine geschäftliche Entscheidung braucht (Preise, Werbetexte, echte Kontaktdaten), erfinde nichts: Frag mich.
## Blocker (solange die bestehen, zählt nichts anderes)
### 1. Die KI sieht nur 0 % deiner Website
**Schweregrad:** Kritisch
**Was passiert:** Ein Mensch liest 160 Wörter auf dem Bildschirm; ein KI-Crawler bekommt 0. Der Unterschied ist Inhalt, der erst im Browser entsteht.
**Warum es wichtig ist:** Wenn ein Modell entscheidet, wen es zitiert, vergleicht es die Inhalte, die es lesen konnte. Fehlt ihm die Hälfte deiner Seite, trittst du mit der Hälfte deiner Argumente an.
**Was zu tun ist:**
Stell den Hauptinhalt auf serverseitiges Rendering um: Texte, Preise, Produktdetails, FAQs und Navigationslinks. Im Client bleibt nur, was interaktiv ist (Warenkorb, Filter, Karten).
### 2. Nur 0 Wörter kommen bei der KI an
**Schweregrad:** Kritisch
**Was passiert:** Das HTML, das der Server ausliefert, enthält 0 Wörter echten Text, gegenüber 160, die ein Mensch auf dem Bildschirm sieht.
**Warum es wichtig ist:** Modelle brauchen Text, um daraus eine Antwort zu ziehen und dich zu zitieren. Mit weniger als 300 Wörtern haben sie kaum etwas in der Hand.
**Was zu tun ist:**
Rendere den Inhalt auf dem Server (SSR/SSG) oder prerendere das HTML: Die KI muss den Text fertig geschrieben in der Antwort bekommen, nicht einen leeren Container.
### 3. Es gibt Inhalte, die die KI nie zu lesen bekommt
**Schweregrad:** Kritisch
**Was passiert:** Diese Texte sind auf dem Bildschirm zu sehen, fehlen aber im HTML, das ein Crawler bekommt:
• Bike repair in Portland
• Full service in 24 hours.
• We collect your bike from home and bring it back ready to ride.
• Gear and brake adjustment, wheel truing, lubrication and a bolt check.
• New 11 or 12-speed chain, with a check of cassette wear.
• Bleed on both brakes, new pads and lever adjustment.
• We assemble it and set it up for your size.
• Over 3,000 bikes serviced since 2016.
**Warum es wichtig ist:** GPTBot, ClaudeBot und PerplexityBot lesen das HTML so, wie es ankommt. Sie warten nicht, bis dein JavaScript gelaufen ist. Alles oben Aufgeführte ist für sie buchstäblich unsichtbar.
**Was zu tun ist:**
Liefere diesen Inhalt vom Server aus. Je nach Stack:
• Next.js: Nutze Server Components oder getStaticProps/generateStaticParams statt useEffect + fetch.
• Nuxt: ssr: true und useAsyncData statt onMounted.
• Reine React/Vue-SPA: Füge Prerendering hinzu (vite-plugin-prerender, react-snap) oder steig auf SSR um.
• CMS mit JS-Widgets: Ersetze das Widget durch statisches HTML oder schreib den Text direkt in den Inhalt.
Prüf das Ergebnis mit: curl -s http://harborcyclery.example/ | grep -i "ein Stück aus dem Text"
<details><summary>Auf der Website gefundener Ausschnitt</summary>
```
Bike repair in Portland
---
Full service in 24 hours.
---
We collect your bike from home and bring it back ready to ride.
---
Gear and brake adjustment, wheel truing, lubrication and a bolt check.
---
New 11 or 12-speed chain, with a check of cassette wear.
```
</details>
## Wichtig
### 1. Keine H1-Überschrift
**Schweregrad:** Hoch
**Was passiert:** Der HTML-Quelltext enthält kein <h1>.
**Warum es wichtig ist:** Die H1 sagt dem Modell, was das Hauptthema ist. Ohne sie (oder mit mehreren) verliert die Seite ihren Fokus, und das Modell weiß nicht, was es eigentlich zusammenfasst.
**Was zu tun ist:**
Füge genau ein <h1> mit dem Hauptthema der Seite ein, so formuliert, wie es ein Kunde sagen würde.
### 2. Die Seite hat keine Überschriften
**Schweregrad:** Hoch
**Was passiert:** Im ausgelieferten HTML wurde keine H1–H6 gefunden.
**Warum es wichtig ist:** An den Überschriften zerschneidet ein Modell die Seite in zitierfähige Abschnitte. Ohne sie ist dein Inhalt eine einzige Textwand: Er wird ganz zitiert oder gar nicht.
**Was zu tun ist:**
Gliedere den Inhalt mit einer H1 und mehreren H2/H3, jeweils formuliert als die Frage, die der Abschnitt beantwortet.
### 3. Du hast keine strukturierten Daten
**Schweregrad:** Hoch
**Was passiert:** Das HTML enthält kein <script type="application/ld+json"> mit schema.org.
**Warum es wichtig ist:** JSON-LD ist der Steckbrief, den ein Modell ohne Missverständnisse liest: Name, Leistungen, Preise, Öffnungszeiten, Bewertungen. Ohne ihn muss die KI aus dem Text raten, liegt öfter daneben oder ignoriert dich und zitiert jemanden, der es ihr leichter macht.
**Was zu tun ist:**
Füge in den <head> einen Block wie diesen ein und passe die Werte an dein Unternehmen an:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "DEINE MARKE",
  "url": "http://harborcyclery.example",
  "logo": "http://harborcyclery.example/logo.png",
  "description": "Was du machst, für wen und wo, in einem Satz.",
  "sameAs": ["https://www.linkedin.com/company/…", "https://www.instagram.com/…"],
  "contactPoint": {
    "@type": "ContactPoint",
    "contactType": "customer service",
    "email": "hello@harborcyclery.example",
    "availableLanguage": ["en"]
  }
}
</script>
### 4. Die Website nutzt kein HTTPS
**Schweregrad:** Hoch
**Was passiert:** http://harborcyclery.example/ wird unverschlüsselt ausgeliefert.
**Warum es wichtig ist:** Ohne HTTPS verlierst du in klassischen Suchmaschinen an Ranking, und mehrere Crawler verwerfen die Domain von vornherein als vertrauenswürdige Quelle.
**Was zu tun ist:**
Installiere ein TLS-Zertifikat (Let's Encrypt ist kostenlos), leite den gesamten HTTP-Verkehr per 301 auf HTTPS um und aktiviere HSTS.
## Weitere Verbesserungen
### 1. Keine sitemap.xml
**Schweregrad:** Mittel
**Was passiert:** http://harborcyclery.example/sitemap.xml antwortet nicht, und die robots.txt gibt keine an.
**Warum es wichtig ist:** Ohne Sitemap findet ein Crawler nur, was von der Startseite aus verlinkt ist. Tiefere Seiten, also genau die, die konkrete Fragen beantworten, werden nie indexiert.
**Was zu tun ist:**
Erzeuge eine sitemap.xml mit allen öffentlichen URLs und ihrem echten <lastmod>, veröffentliche sie unter http://harborcyclery.example/sitemap.xml und trag sie mit dieser Zeile in die robots.txt ein:
Sitemap: http://harborcyclery.example/sitemap.xml
### 2. Kein Ersatzinhalt ohne JavaScript
**Schweregrad:** Mittel
**Was passiert:** Die Seite hängt von JS ab und hat kein <noscript> mit dem wesentlichen Inhalt.
**Warum es wichtig ist:** Solange du am serverseitigen Rendering arbeitest, gibt ein ordentliches <noscript> der KI wenigstens den Haupttext statt gar nichts.
**Was zu tun ist:**
Als vorübergehender Behelf: Pack die Überschrift, die zwei oder drei wichtigsten Absätze und die Hauptlinks in <noscript>. Die eigentliche Lösung bleibt, gerendertes HTML auszuliefern.
### 3. Der Titel ist nicht optimiert
**Schweregrad:** Mittel
**Was passiert:** Der <title> ist 14 Zeichen lang: „Harbor Cyclery“.
**Warum es wichtig ist:** Der Titel ist das Erste, was ein Modell liest, um zu entscheiden, worum es auf der Seite geht und ob sie die Frage des Nutzers beantwortet.
**Was zu tun ist:**
Schreib einen Titel mit 50–60 Zeichen nach dem Muster „Dein Angebot | Marke“ und nimm die Begriffe, die deine Kunden eintippen würden, wenn sie eine KI fragen.
<details><summary>Auf der Website gefundener Ausschnitt</summary>
```
Harbor Cyclery
```
</details>
### 4. Die Meta-Description fehlt
**Schweregrad:** Mittel
**Was passiert:** Im HTML fehlt <meta name="description">.
**Warum es wichtig ist:** Viele KI-Systeme nehmen die Beschreibung als maßgebliche Zusammenfassung der Seite, noch bevor sie den eigentlichen Inhalt lesen.
**Was zu tun ist:**
Füge eine Beschreibung mit 140–160 Zeichen ein, die in einem Satz sagt, was du machst, für wen und wo:
<meta name="description" content="…">
### 5. Die Seite nutzt kein semantisches HTML
**Schweregrad:** Mittel
**Was passiert:** Kein <main>, <article>, <nav> oder <header>: Alles ist ein <div>.
**Warum es wichtig ist:** Semantische Tags zeigen dem Extraktor, was Inhalt ist und was Menü oder Footer. Ohne sie vermischt sich dein Text mit der Navigation, und das Modell zitiert dich schlechter.
**Was zu tun ist:**
Pack den Hauptinhalt in <main>, jeden eigenständigen Block in <article>, das Menü in <nav> und den Footer in <footer>. Du ersetzt nur divs durch Tags mit Bedeutung, an den Styles änderst du nichts.
### 6. Keine Links im ausgelieferten HTML
**Schweregrad:** Mittel
**Was passiert:** Das Dokument enthält kein einziges <a href>.
**Warum es wichtig ist:** Wenn die Navigation per JavaScript erzeugt wird, findet ein KI-Crawler den Rest deiner Website nicht: Er indexiert nur diese eine Seite.
**Was zu tun ist:**
Liefere das Menü als echte <a href>-Links im HTML aus, nicht als Buttons mit onClick.
### 7. Die KI weiß nicht, wer du bist
**Schweregrad:** Mittel
**Was passiert:** Es gibt kein Schema vom Typ Organization, LocalBusiness oder Person.
**Warum es wichtig ist:** KIs empfehlen Entitäten, keine einzelnen URLs. Wenn du Name, Tätigkeitsbereich und Kontaktdaten nicht angibst, ordnen sie dich weder deiner Branche noch deiner Stadt zu.
**Was zu tun ist:**
Füge einen Organization-Block hinzu (oder LocalBusiness, wenn du Kunden an einer festen Adresse empfängst), mit name, url, logo, description, sameAs (deine Social-Media-Profile) und, falls zutreffend, address und areaServed.
### 8. Deine Zwischenüberschriften beantworten nicht die Fragen, die Menschen stellen
**Schweregrad:** Mittel
**Was passiert:** Die Seite hat keine H2/H3-Zwischenüberschriften.
**Warum es wichtig ist:** KIs suchen das Textstück, das die Frage des Nutzers wörtlich beantwortet. Eine H2 wie „Unsere Leistungen“ passt auf nichts; „Was kostet eine Badsanierung in München?“ passt auf eine echte Frage.
**Was zu tun ist:**
Formuliere mindestens 3 Zwischenüberschriften als genau die Frage, die dir ein Kunde stellen würde, und antworte im ersten Absatz darunter in 2–3 Sätzen. Beispiel: „## Wie lange dauert eine Badsanierung?“, gefolgt von „Zwei bis drei Wochen für ein Standardbad mit 5 m²…“.
### 9. Keine direkte Antwort in den ersten Zeilen
**Schweregrad:** Mittel
**Was passiert:** Die Seite beginnt ohne einen Absatz, der zusammenfasst, worum es geht.
**Warum es wichtig ist:** Ein Modell zitiert meist die ersten 40–60 Wörter, die die Anfrage beantworten. Wenn du mit Werbefloskeln einsteigst, findet es nichts, was es herausziehen kann.
**Was zu tun ist:**
Beginne die Seite mit einem Absatz von 40–70 Wörtern, der wörtlich antwortet: was es ist, für wen, was es kostet oder wie lange es dauert. Die Ausschmückungen kommen danach.
### 10. Kein Block mit häufigen Fragen
**Schweregrad:** Mittel
**Was passiert:** Es wurde kein Bereich mit häufigen Fragen erkannt.
**Warum es wichtig ist:** Eine FAQ mit strukturierten Daten ist das Frage-Antwort-Format, das KI-Suchmaschinen direkt verarbeiten: Jedes Paar ist eine fertige Antwort, mit deiner Marke daneben.
**Was zu tun ist:**
Füge 5–8 echte Kundenfragen mit Antworten hinzu (je 2–4 Sätze) und zeichne sie so aus:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "Was kostet die Leistung?",
    "acceptedAnswer": {"@type": "Answer", "text": "Ab 300 € für ein Standardprojekt…"}
  }]
}
</script>
Nimm die Fragen, die du schon per E-Mail oder WhatsApp bekommst: Genau die tippen die Leute in eine KI.
### 11. Keine llms.txt-Datei
**Schweregrad:** Niedrig
**Was passiert:** http://harborcyclery.example/llms.txt existiert nicht.
**Warum es wichtig ist:** llms.txt ist ein aufkommender Standard (noch nutzen ihn nicht alle Suchmaschinen), mit dem du einem Modell sagst, welche deiner Seiten wichtig sind und in welcher Reihenfolge es sie lesen soll. Das kostet zehn Minuten, und du bist vorbereitet, wenn er sich durchsetzt.
**Was zu tun ist:**
Erstelle http://harborcyclery.example/llms.txt in Markdown:
# harborcyclery.example

> Ein Satz, der beschreibt, was dein Unternehmen macht und für wen.

## Wichtigste Seiten
- [Leistungen](http://harborcyclery.example/services): was du genau anbietest.
- [Preise](http://harborcyclery.example/pricing): Tarife und Pakete.
- [Kontakt](http://harborcyclery.example/contact): wie man dich beauftragt.
### 12. Open-Graph-Metadaten fehlen
**Schweregrad:** Niedrig
**Was passiert:** Fehlende Tags: og:title, og:description, og:image.
**Warum es wichtig ist:** Mehrere Assistenten nutzen Open Graph als Kurzzusammenfassung, wenn sie deinen Link in einer Antwort anzeigen.
**Was zu tun ist:**
Ergänze im <head>:
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="http://harborcyclery.example/cover.jpg">
<meta property="og:url" content="http://harborcyclery.example/">
<meta property="og:type" content="website">
### 13. Deinen Links fehlt die Vorschaukarte
**Schweregrad:** Niedrig
**Was passiert:** Es wurde kein <meta name="twitter:card"> gefunden.
**Warum es wichtig ist:** Wenn jemand deinen Link in X, Slack, WhatsApp oder Discord einfügt, erscheint er ohne Karte als graue Textzeile, die niemand anklickt. Mit Bild nimmt er zehnmal so viel Platz ein und wird viel häufiger geteilt.
**Was zu tun ist:**
Ergänze im <head>:
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="http://harborcyclery.example/twitter-image.png">
Das Bild muss 1200×630 px groß sein. Mit Next.js kannst du es per Code erzeugen, mit einer opengraph-image.tsx und einer twitter-image.tsx. So veraltet es nie.
### 14. Die kanonische URL fehlt
**Schweregrad:** Niedrig
**Was passiert:** Die Seite gibt kein <link rel="canonical"> an.
**Warum es wichtig ist:** Ohne Canonical zählt derselbe Inhalt unter mehreren URLs (mit und ohne www, mit Parametern, http und https) als verschiedene Seiten, und deine Autorität verteilt sich auf alle.
**Was zu tun ist:**
Ergänze im <head>: <link rel="canonical" href="http://harborcyclery.example/">
### 15. Wenig Inhalt in Listen oder Tabellen
**Schweregrad:** Niedrig
**Was passiert:** Die Seite hat nur 0 Listenpunkte und 0 Tabellen.
**Warum es wichtig ist:** Listen und Tabellen übernimmt ein Modell am genauesten, weil sie schon in vergleichbare Einheiten zerlegt sind (Preise, Schritte, Merkmale).
**Was zu tun ist:**
Mach aus deinen Arbeitsschritten und aus dem, was jede Leistung umfasst, Listen und aus deinem Paket- oder Preisvergleich eine Tabelle. Du formatierst nur um, was du schon geschrieben hast.
### 16. Der Inhalt nennt keine konkreten Zahlen
**Schweregrad:** Niedrig
**Was passiert:** Auf der ganzen Seite wurden nur 0 Zahlen mit Einheit gefunden.
**Warum es wichtig ist:** KIs zitieren lieber überprüfbare Aussagen. „Wir sind Branchenführer“ lässt sich nicht zitieren; „wir liefern in 48 Stunden, und die Installation kostet 149 €“ schon, und die Zahl nimmt deine Marke mit.
**Was zu tun ist:**
Nenn echte Zahlen: Preise ab, Lieferzeiten, Jahre am Markt, abgeschlossene Projekte, prozentuale Ersparnis. Eine Zahl pro Abschnitt.
### 17. Der Inhalt wirkt veraltet
**Schweregrad:** Niedrig
**Was passiert:** Es gibt keine Datumsangaben und keinen Bezug auf das aktuelle Jahr.
**Warum es wichtig ist:** Sagen zwei Quellen dasselbe, zitieren KI-Suchmaschinen die, die belegt, dass sie aktuell ist. Eine Seite ohne Zeitangaben gilt als alt.
**Was zu tun ist:**
Überprüfe und aktualisiere den Inhalt, zeig das Datum der letzten Prüfung auf der Seite an und aktualisiere „dateModified“ im JSON-LD. Auch wenn sich deine Angaben selten ändern, schreib „Aktualisiert 2026“ dazu, wo es stimmt, aber nie, wenn du nichts überprüft hast. Analysierte Seite: /
### 18. Das HTML wird unkomprimiert gesendet
**Schweregrad:** Niedrig
**Was passiert:** Die Antwort hat keinen Content-Encoding-Header.
**Warum es wichtig ist:** Komprimierung macht HTML um 70–80 % kleiner. Weniger Bytes heißen weniger Ladezeit pro Seite und mehr gecrawlte Seiten beim selben Budget.
**Was zu tun ist:**
Aktiviere gzip oder brotli auf deinem Server (Nginx: gzip on; Apache: mod_deflate) oder stell ein CDN davor, das es für dich übernimmt.
## Inhalte, die die KI heute nicht lesen kann
Diese Texte sind im Browser sichtbar, stehen aber NICHT im HTML, das der Server ausliefert. Sorg dafür, dass sie am Ende alle im initialen HTML stehen:
- "Bike repair in Portland"
- "Full service in 24 hours."
- "We collect your bike from home and bring it back ready to ride."
- "Gear and brake adjustment, wheel truing, lubrication and a bolt check."
- "New 11 or 12-speed chain, with a check of cassette wear."
- "Bleed on both brakes, new pads and lever adjustment."
- "We assemble it and set it up for your size."
- "Over 3,000 bikes serviced since 2016."
- "A fixed quote before we touch anything."
- "Six-month guarantee on every repair."
## So baust du das Bild, das beim Teilen des Links erscheint
Dein Link braucht ein Bild mit 1200×630 px für Open Graph (Facebook, LinkedIn, WhatsApp, Slack) und eines für die Twitter Card (X). Es darf dieselbe Datei sein.
**Wenn das Projekt Next.js (App Router) nutzt, erzeuge die Bilder per Code**, damit sie nie veralten. Lege `app/opengraph-image.tsx` an:
```tsx
import { ImageResponse } from "next/og";
export const alt = "Harbor Cyclery";
export const size = { width: 1200, height: 630 };
export const contentType = "image/png";
export default function Image() {
return new ImageResponse(
(
<div
style={{
width: "100%",
height: "100%",
display: "flex",
flexDirection: "column",
justifyContent: "center",
padding: "80px",
// Ein diagonaler Verlauf gibt Tiefe, ganz ohne Bilder.
background: "linear-gradient(135deg, #0b1020 0%, #1b1038 60%, #2a1458 100%)",
color: "#ffffff",
fontFamily: "sans-serif",
}}
>
<div style={{ fontSize: 26, opacity: 0.75 }}>harborcyclery.example</div>
<div style={{ marginTop: 32, fontSize: 64, fontWeight: 700, lineHeight: 1.08, letterSpacing: -2 }}>
DEINE HAUPTAUSSAGE, DIESELBE WIE IN DER H1
</div>
<div style={{ marginTop: 34, fontSize: 28, color: "#c4b5fd", maxWidth: 940 }}>
Eine ergänzende Zeile: was du anbietest und für wen.
</div>
</div>
),
size,
);
}
```
Lege dann `app/twitter-image.tsx` an, das dasselbe re-exportiert, damit beide Karten übereinstimmen:
```tsx
export { default, alt, size, contentType } from "../opengraph-image";
```
Next erzeugt die Tags `og:image` und `twitter:image` dann selbst. Setze `metadataBase: new URL("https://DEINE-DOMAIN")` im Root-Layout, damit die URLs absolut sind: Relative URLs ignorieren die meisten Crawler.
**Wenn das Projekt kein Next.js nutzt**, exportiere ein PNG mit 1200×630 und unter 1 MB, leg es unter `/og-image.png` ab und trag die Tags von Hand ein:
```html
<meta property="og:title" content="…">
<meta property="og:description" content="…">
<meta property="og:image" content="https://DEINE-DOMAIN/og-image.png">
<meta property="og:image:width" content="1200">
<meta property="og:image:height" content="630">
<meta property="og:url" content="https://DEINE-DOMAIN/">
<meta property="og:type" content="website">
<meta name="twitter:card" content="summary_large_image">
<meta name="twitter:title" content="…">
<meta name="twitter:description" content="…">
<meta name="twitter:image" content="https://DEINE-DOMAIN/og-image.png">
```
Regeln, die den Unterschied machen:
- Genau 1200×630 px. Andere Seitenverhältnisse werden beschnitten, und der Text geht verloren.
- Auch als Vorschaubild lesbar: die Hauptaussage in 60 px oder größer, höchstens drei Zeilen.
- Das Bild wiederholt das Versprechen der Seite. Es ist kein Logo auf einem Hintergrund.
- Absolute URLs mit Protokoll. Ein relativer Pfad scheitert, ohne dass du es merkst.
- Unter 1 MB, als PNG oder JPEG. WebP lesen noch nicht alle Scraper.
- Prüf es unter https://cards-dev.twitter.com/validator und indem du den Link in einen Slack- oder WhatsApp-Chat mit dir selbst einfügst.
## So prüfst du, ob alles behoben ist
Wenn du fertig bist, führ diese Prüfungen aus und zeig mir das Ergebnis:
```bash
# 1. Das sieht ein KI-Crawler WÖRTLICH (ohne JavaScript auszuführen).
curl -sL "http://harborcyclery.example/" | sed 's/<script[^>]*>.*<\/script>//g; s/<[^>]*>//g' | tr -s ' \n' | head -60
# 2. Der Server darf KI-Bots nicht blockieren (erwartet: überall 200).
curl -sL -o /dev/null -w "OAI-SearchBot: %{http_code}\n" -A "OAI-SearchBot" "http://harborcyclery.example/"
curl -sL -o /dev/null -w "Claude-SearchBot: %{http_code}\n" -A "Claude-SearchBot" "http://harborcyclery.example/"
curl -sL -o /dev/null -w "PerplexityBot: %{http_code}\n" -A "PerplexityBot" "http://harborcyclery.example/"
# 3. robots.txt darf kein Disallow enthalten, das diese Agents betrifft.
curl -s "http://harborcyclery.example/robots.txt"
```
Ziel ist, dass der Text aus Schritt 1 alle wichtigen Inhalte der Seite enthält. Was dort nicht steht, existiert für die KI nicht.
---
Bericht erstellt von Tarsier · http://harborcyclery.example/ · 36/100